itmo_conspects
Тестирование ПО. Трек от Яндекса
- Тестирование ПО. Трек от Яндекса
- Лекция 1. Введение в тестирование
- Лекция 2. Требования к ПО
- Лекция 3. Проектирование тестов
- Лекция 4. Классы эквивалентности и анализ граничных значений
- Лекция 5. Таблицы решений и комбинации условий
- Лекция 6. Тестирование переходов состояний
- Лекция 7. Исследовательское тестирование
- Лекция 8. Дефекты и баг-репорты
Курс разделен на 4 блока:
- Требования и тестируемость
- Как спроектировать проверки
- Дефекты
- Автоматизация проверок
Лекция 1. Введение в тестирование
Соответствие требованиям чаще всего не означает, что продукт качествен. Продукт может соответствовать требованиям, оставаться стабильным и проходить все тесты, но может не решать нужную задачу или быть неустойчивым в эксплуатации
У качества есть 4 основные метрики:
- Поведение - делает ли система то, что от нее требуется?
- Характеристики качества - насколько она удобна, быстра, надежна и безопасна?
- Результат использования - может ли пользователь решить свою задачу?
- Эксплуатация - можно ли обнаружить сбой и после него восстановиться?
Ведь проблема с продуктом может появиться в: составлении требований, дизайне продукта, его разработке, конфигурации и эксплуатации. Поэтому работа с качеством включает предотвращение проблем, получение информации, управление рисками и обучение на результатах и инцидентах
Рассмотрим ключевые термины
- Тестирование - это деятельность по оценке продукта и связанных с ним артефактов, направленная на выявление проблем и получение информации о качестве
- Обеспечение качества (QA, от Quality Assurance) - область, которая изучает то, как изменить способ работы, чтобы проблемы с качеством возникали реже
- Контроль качества (QC, от Quality Control) - область, которая изучает, соответствует ли полученный результат установленным критериям
Важно заметить, что обеспечение качества направлено на предотвращение дефектов, а контроль качества - на их обнаружение
- Ошибка (error) - это ошибка человека, то есть непреднамеренное отклонение от правильных действий
- Дефект (defect) - это несоответствие продукта требования
- Сбой (failure) - это наблюдаемый отказ системы
Приведем пример: форма регистрации требует, чтобы возраст человека был не меньше 18. Если пользователь вводит 18, а система дает отказ, то это может быть:
- Ошибка, если пользователь ввел свою дату рождения неправильно
- Дефект, если требуется возраст
>= 18, а в коде стоит условие> 18 - Сбой, если явно подразумевалось аналитиками, что возраст должен быть больше 18
На практике симптом редко указывает на истинную причину. Корень проблемы может лежать глубже - в коде, данных, конфигурации или даже в исходных требованиях
- Верификация - это проверка соответствию наблюдаемого поведения продукта требованиям, спецификации, архитектурным решениям и установленным критериям. Верификацией может быть ревью требований
- Валидация - это проверка на то, решает ли продукт нужную задачу, подходит ли реальным пользователям и можно ли эффективно использовать его по назначению
Рассмотрим 7 важных принципов тестирования:
- Тесты показывают наличие дефектов, но никак не их отсутствие
- Из первого следует, что проверить все дефекты невозможно. Полное покрытие тестами всех возможных дефектов в сложной системе невозможно из-за того, что число возможных состояний чересчур огромно. Поэтому нужны приоритеты того, что проверять
- Тестировать нужно как можно раньше. На ранних этапах разработки исправить дефект, который возник из требований, проще, быстрее и дешевле
- Дефекты обычно концентрируются. Связано это может быть со сложными бизнес-правилами, частыми изменениями, количеством интеграций или накопленным техническим долгом
- Тесты имеют свойство устаревать. Изменения в продукте могут изменять условия, при которых тесты хорошо работали
- Тестирование зависит от контекста. Для разных продуктов приоритеты к тому, что тестировать, разные, так как ошибки в ПО в разных областях имеют разные риски. Контекст определяет приоритет проверок и допустимый риск совершения ошибки
- Продукт без дефектов может быть бесполезен. Продукт может соответствовать спецификации, не иметь дефектов, быть стабильным, но может не решать задачу пользователя
Однако после того, как все запланированные тесты успешно прошли, какой вывод можно сделать? Можно сделать вывод, что продукт соответствует запланированным критериям качества и требованиям, но это не гарантирует отсутствия скрытых дефектов и не доказывает его полезности для пользователей. Тестирование лишь дает информацию о качестве, но не является его абсолютной мерой
Рассмотрим, как тестирование работает в различных моделях разработки:
- В каскадной модели разработки тестирование происходит после разработки всего продукта. Большинство проблем может возникнуть на этапе проектирования, что выяснится на этапе тестирования и что приведет к пересмотру дизайна и реализации. Каскадная модель чаще всего применяется для стандартизированных продуктов
- В V-модели разработка разделена на два этапа - проектирование продукта и его реализация, поэтому можно проектировать проверки до готовой реализации
- В итеративной разработке применяют итеративное тестирование. В итерациях тестирование является частью цикла, поэтому оно происходит на всем протяжении разработки
Обычно цикл тестирования проводят параллельно циклу разработки и является обратной связью для разработки:
- При разработке требований происходит их анализ, на основе которого требования правятся
- При проектировании архитектуры планируются интеграционные проверки
- Реализация дополняется динамическими тестами
- При изменении компонентов происходит подтверждение того, что измененный компонент и все смежные с ним работают корректно
- При релизе учитываются возможные риски и готовность к ним
Тесты обычно делят по уровню:
- Тестирование отдельных компонентов, таких как функции, классы, модули и так далее
- Интеграционное тестирование того, как компоненты хорошо интегрируются друг с другом
- Системное тестирование того, как система работает как единое целое
- Приемочное тестирование - то, насколько пригодна система для использования и для принятия заказчиком
Также тесты делятся:
- По цели:
- Функциональные тесты проверяют требуемое поведение
- Нефункциональные тесты проверяют характеристики качества - удобство, совместимость с браузерами, производительность, надежность, безопасность
- По способу:
- Статическое тестирование - ревью требований, кода, статический анализ кода
- Динамическое тестирование - тестирование при выполнении программы или ее отдельных компонентов
- По тест-дизайну:
- “Черный ящик” (black box) - тестирование функции как черной коробки, когда известен лишь ее ввод и ожидаемое поведение
- “Белый ящик” (white box) - тестирование функции с известной реализации
- Основанное на опыте (experience-based) - тестирование, основанное на интуиции, знаниях и предыдущем опыте тестировщика
- По отношению к изменению:
- Подтверждающее тестирование, проверяющее работу нового или измененного функционала
- Регрессионное тестирование, проверяющее работоспособность остального функционала
Лекция 2. Требования к ПО
Перед началом разработки к ПО составляются требования - это формализованные утверждения, выражающие потребность, которую должно удовлетворять программное обеспечение, а также связанные с этой потребностью условия и ограничения
Даже если требования понятны и интерпретируются заказчиками и разработчиками одинаково, могут возникнуть другие проблемы, например, насколько требования реализуемы
Для проверки требований существуют два процесса:
- Верификация требований - проверка на соответствие продукта требованиям
- Валидация требований - проверка на соответствие продукта реальным потребностям
Требования задают общий контракт понимания между заказчиками и разработчиками
Требования разделяют:
-
По функции (то есть функциональные) - что система должна делать
Функциональные требования описывают то, как функция должна работать, то есть какой наблюдаемый результат должен быть при определенных условиях после действия системы. Например:
Зарегистрированный пользователь должен иметь возможность войти с использованием верных электронной почты и пароля
Здесь присутствуют:
- Условия или события - зарегистрированный пользователь с правильными данными для входа
- Система - сервис авторизации
- И наблюдаемый результат - пользователь получает доступ
Требования должны описывать не только хорошие сценарии (так называемый happy path, “счастливый путь”), но и плохие, например, “Зарегистрированный пользователь не должен иметь возможность войти с использованием неверного пароля”
-
И по характеристикам (то есть нефункциональные) - какими характеристиками обладает функция или система в целом
Нефункциональные требования описывают характеристики системы. Например, время ответа на запрос:
При штатной нагрузке не менее 95% запросов авторизации должны обрабатываться не более 1 секунды
Для нефункционального требования важно обозначить измеримое качество. Для этого нужно определить:
- Измеряемую метрику, например, время ответа
- Порог измерения, преодолев который тест считается не пройденным, например, “не более 1 секунды”
- Доли наблюдения событий, для которых выбранная метрика не преодолевает порог, например “не менее 95% запросов”
- И условия наблюдения, для которых измеряется метрика
В нефункциональных требованиях нельзя использовать слова “быстро”, “понятно” и другие, так как такие слова по-разному толкуют качественную меру функции
У требования есть 5 основных качеств, которые задают то, насколько оно правильно сформулировано:
-
Однозначность
Требование считается однозначным, если оно может быть растолковано одинаково для всех
Например, требование “После нескольких неуспешных попыток вход временно блокируется” плохое, потому что не указано:
- Сколько должно быть попыток, как они считаются, в течение которого срока
- На какой срок блокировка происходит
- Что именно блокируется после неудачных попыток
Чаще всего, если в требовании есть такие слова, то оно неоднозначно: “удобно”, “быстро”, “просто”, “современно”, “оптимальный”, “подходящий”, “достаточно”, “и так далее”, “при необходимости”, “надёжно”, “по возможности”, “обычно”
Неоднозначность может быть скрытой, например:
Если пользователь отменил заказ после оплаты, система возвращает деньги и уведомляет его после проверки
В этом требовании не указано, что такое проверка, что именно проверяется, кто проверяет, когда и при каких условиях
-
Полнота
Хорошее требование должно описывать всю нужную информацию, необходимую для его понимания
Требование
После трех неверных паролей учетная запись блокируется
является плохим, так как не описано: срок блокировки, способ разблокировки, поведение при правильном пароле и так далее
При этом требование не должно быть избыточным или перегруженным лишними деталями, например деталями реализации
-
Непротиворечивость
В хорошем наборе требований они не должны противоречить друг другу
Требования “пароль должен состоять из больше 20 символов” и “пароль должен состоять из менее 15 символов” плохие
Обычно противоречивость возникает из-за множества источников принятия решений
-
Корректность
Хорошее требование должно удовлетворять потребность бизнеса
Требование “Пароль должен состоять из 30 или более символов” плохое, потому что пользователю не представляется удобным запоминать 30 символов, а бизнес страдает от недовольных пользователей
Требование “После одного неверного пароля учётная запись блокируется на 30 дней” тоже плохое. Несмотря на то, что оно однозначно, измеримо и легко проверяется, такое требование вряд ли соответствует бизнес-целям и пользовательским сценариям
-
Тестируемость
Хорошее требование должно быть тестируемым
Требование “Интерфейс должен быть интуитивно понятным” плохое, потому что не описывает, что считается “интуитивно понятным” и как это тестировать
Вместо этого “понятность” интерфейса можно оценить с помощью целевой группы пользователей, которые будут проверять этот интерфейс. Тогда требование станет таким:
Не менее 90% участников целевой группы должны самостоятельно оформить заказ по заданному сценарию без помощи модератора
Из этих качеств выделяется общая структура требования:
- Условие, например, активная учетная запись
- Воздействие, например, ввод 5 неправильных паролей
- Результат, например, блокировка входа
- Критерий успеха, например, длительность блокировки
Чаще всего плохое требование декомпозируется в набор хороших, например:
Пользователь должен быстро и безопасно войти в интернет-магазин
Такое требование плохое, но его можно разделить в набор хороших:
1) Зарегистрированный пользователь может войти с использованием электронной почты и пароля 2) После пяти последовательных неверных паролей вход блокируется на 15 минут 3) Для 95% запросов авторизации время ответа не превышает 1 секунды при заданной штатной нагрузке (500 пользователей)
Помимо этих основных 5 качеств также можно выделить:
- Атомарность - одно требование должно описывать одну самостоятельную потребность, функцию или условие
- Реализуемость - требование должно быть выполнимо с учётом технологий, ресурсов, сроков и ограничений проекта. Часто реализуемость оценивает не тестировщик, а соответствующий инженер
- Измеримость - по возможности требование должно содержать конкретные количественные показатели или критерии оценки
- Конкретность - требование должно описывать чётко определённую потребность или ожидаемый результат
- Прослеживаемость - должна быть установлена связь требования с его источником, целями, реализацией и тестами
Для проверки требования также составляются критерии приемки. Для составления критериев приемки можно использовать схему Given-When-Then (Дано-Когда-Тогда):
- Given - исходное состояние, контекст (например, “Зарегистрированный пользователь находится на странице входа”)
- When - действие или событие (например, “Пользователь вводит корректные электронную почту и пароль”)
- Then - ожидаемый результат (например, “Система выполняет авторизацию и открывает личный кабинет”)
Для требования также полезно проводить трассировку - процесс создания и отслеживания связей между требованиями проекта и другими его артефактами на всех этапах жизненного цикла. Трассировка проводится для анализа влияния (насколько другие части системы изменятся, если изменить или добавить требование), контроля покрытия (того, что каждое требование реализовано и проверено тестами) и прозрачности
Зачастую набор требований в текстовом виде плохо анализировать на непротиворечивость, поэтому используют другие модели: таблицы решений, диаграммы состояний или прототип функционала
Для проверки требований осуществляют ревью. Как правило, есть три типа ревью требований (от мере возрастания формальности):
- Неформальное ревью (Peer review) - коллега из команды может оценить и проверить требование
- Пошаговый разбор (Walkthrough) - автор требований последовательно проводит участников по тексту требований и собирает замечания
- Техническое ревью (или инспекция) - эксперты анализируют требования, чтобы убедиться в технической осуществимости и рисках реализации
Требования проверяют разные роли в компании: заказчик может проверить, действительно нужно ли это требование, аналитик проверяет на полноту, разработчик на реализуемость, тестировщик на тестируемость и так далее
Если требование описывает поведение неясно или не описывает вообще, то лучше это зафиксировать и обратиться к аналитикам за уточнением
Подытожим, требование должно:
- иметь одно толкование
- содержать достаточно информации и описание альтернативных сценариев
- не иметь конфликтов
- соответствовать потребности бизнеса/пользователя
- тестируемо
Процесс создания требований превращается в цикл:
- Сбор и выявление - общение с заказчиком и пользователями, определение целей и проблем
- Анализ и моделирование - оценка требований на непротиворечивость, полноту, реализуемость и важность
- Спецификация и документирование - фиксация требований в виде текстовых документов
- Согласование и утверждение - защита спецификации перед заказчиком и одобрение
- Трассировка и управление изменениями - связка требований с задачами в разработке и тестами
- Проверка и приемочное тестирование - контроль того, что готовый продукт соответствует написанному требованию
Лекция 3. Проектирование тестов
После составления требований их нужно преобразовать в конкретные тесты. Ключевая проблема при создании тестов - это определить их количество, которое покажет, что конкретное требование выполняется в системе
Как правило, одно требование может включать множество аспектов (например, авторизация пользователя, ограничение на ввод)
Для этого из каждого требования нужно извлечь тестовые условия - конкретные аспекты (свойства, правила, состояния, результаты) компонента или системы, который должен быть проверен в ходе тестирования. Например, у требования:
Авторизованный пользователь может добавить в корзину от 1 до 10 единиц доступного товара
есть 4 тестовых условия, которые нужно проверить:
- Авторизация пользователя
- Возможность добавления товара в корзину
- Допустимое количество товара (то есть диапазон от 1 до 10)
- Достаточный складской остаток товара
Декомпозиция требования на условия осуществляется буквально вычленяя словосочетания из требования. Так как тестовое условие - это описание свойства функции, важно, чтобы уровень детализации не был настолько избыточным, что тестовое условие превращается в тест-кейс
Далее из тестовых условий формируются тестовые сценарии - описания ситуации или условий функционирования тестируемого объекта, используемое в качестве основы для определения и разработки соответствующих тест-кейсов
Если тестовое условие отвечает на вопрос “что проверяется?”, то тестовый сценарий отвечает на вопрос “в какой именно ситуации это проверяется?”. Тестовые сценарии описывают варианты поведения, в которых нужно проверять одно конкретное тестовое условие
Разные тестовые сценарии появляются из-за вариативности, которая создается благодаря:
- Разным состояниям (например, когда корзина пуста или заполнена)
- Разным пользователям (например, когда действует гость или авторизованный пользователь)
- Разным данным (например, наличие или отсутствие товара)
- Разным последовательностям (например, попытка оплаты до добавления товара в корзину)
- Разным зависимостям (например, доступность интеграций сервиса)
Далее тестовые сценарии превращаются в тест-кейс (от англ. Test Case) - набор предусловий, входных данных, действий и ожидаемых результатов, определяющий конкретную проверку тестируемого объекта и предназначенный для достижения установленной цели тестирования
Тест-кейс состоит из 6 элементов:
-
Название или идентификатор тест-кейса
Название должно кратко и конкретно описывать проверяемое правило в этом тесте (например, условие + ожидаемое поведение)
- Предусловия - набор состояний и условий тестовой среды, тестовых данных и тестируемого объекта, которые должны быть выполнены до начала выполнения тест-кейса
-
Тестовые данные, на которых будет проверяться тест
Тестовые данные - данные, созданные или выбранные для использования в качестве входных данных при выполнении одного или нескольких тест-кейсов в соответствии с целями и условиями тестирования
Тестовые данные могут описывать значения, пользователей, объекты, состояния, связи или историю
Чтобы проверка была воспроизводимой, важно после тестирования вернуть систему в исходное состояние
-
Шаги взаимодействия с системой в ходе теста
Разделение между предусловиями и шагами взаимодействия зависит от того, что проверяется в тесте. Например, при проверки авторизации вход пользователя в систему является шагом, а при проверки работоспособности корзина авторизация является предусловием
- Ожидаемый результат - заранее определенное наблюдаемое поведение или состояние тестируемого объекта при заданных условиях, установленное на основании требований или другого источника. Как правило, ожидаемый результат - это изменение данных в базе данных, изменение пользовательского интерфейса, появление события, переход в другое состояние и так далее
- Ссылка на требование или другой артефакт, который объясняет, зачем появился этот тест-кейс
Одна из проблем, которая появляется при создании тест-кейса, - это перегруженность, при которой проверяется множество условий одновременно, каждое из которых зависит от предыдущего
На основе сравнения ожидаемого и реального результатов образуется вердикт проверки:
- Пройден (Passed) - система выдала тот результат, который ожидался (то есть успех🐱)
- Провален (Failed) - ожидаемый и фактический результаты не совпали, обнаружен новый дефект
- Заблокирован (Blocked) - тест-кейс невозможно выполнить из-за дефекта в предыдущем шаге или в зависимой функциональности
- Провален из-за известного дефекта (Bugged) - тест-кейс провален из-за уже известного дефекта
- Прерван (Broken) - невозможность установить предусловия (например, тестовый стенд не работает)
- Пропущен (Skipped) - проверка тест-кейса была пропущена (например, потому что этот тест-кейс в данный момент незначителен)
Вместо тест-кейсов можно создать чек-лист - структурированный перечень тестовых условий, характеристик или аспектов тестируемого объекта, каждый из которых подлежит отдельной проверке в процессе тестирования
Чек-лист хорошо подходит вместо тест-кейсов, если:
- Проверяемый функционал простой и хорошо знаком
- Риск ошибиться мал, или команда, работающая над функцией, достаточно опытная
- Важна скорость обновления, а не повторяемость проверки
- Детали очевидны из контекста
Обычно для одного продукта чек-листы и тест-кейсы комбинируются для проверки разного функционала
Тестирование можно разделить на два вида:
- Позитивное тестирование - тестирование, направленное на подтверждение корректной работы компонента или системы при использовании допустимых входных данных и ожидаемых условий эксплуатации (то есть проверка “счастливых путей” - happy path)
-
Негативное тестирование - тестирование компонента или системы в условиях или способом, не предусмотренными их штатным использованием, с целью проверки корректности поведения при некорректных, недопустимых или неожиданных воздействиях
Негативное тестирование может включать проверку:
- Значений (например, отправили строку, где ожидается число)
- Формата данных
- Состояния (например, попытка отмены уже отмененного заказа)
- Последовательности действий
- Попытку совершить действие, на которое у пользователя недостаточно прав
- Существования объектов
- Зависимостей и так далее
Негативные тесты не должны быть хаотичными, поэтому они также должны быть основаны на тестовых условиях и на рисках, которые появляются
Обычно позитивные и негативные проверки связаны, так как они проверяют то, что правило разрешает, и то, что оно запрещает. При этом нельзя пренебрегать позитивными проверками - нет смысла проверять, работает ли функция неправильно, если она вообще не работает правильно
Важно соблюдать трассируемость тестов: если изменилось требование, то нужно соответствующе изменить тестовые условия, сценарии и тест-кейсы. Такой подход также позволяет проверять, какие требования еще не были покрыты тест-кейсами
Лекция 4. Классы эквивалентности и анализ граничных значений
Одними из техник проектирования проверок являются классы эквивалентности и анализ граничных значений
Возьмем пример: есть требование “Возраст пользователя должен быть от 18 до 65 лет включительно”. Так как возраст - целое неотрицательное число, то можно разбить числовой промежуток $[0; +\infty)$ на три диапазона: $[0; 17]$, $[18; 65]$ и $[66; +\infty)$
Из этих трех только один диапазон, $[18; 65]$, является валидным, а классы $[0; 17]$ и $[66; +\infty)$ невалидны. Тут важно не только проверять числа из каждого диапазона, но и проверять числа на границах между диапазонами, чтобы исключить дефекты из-за неправильной реализации (например, поставлено условие > 18 вместо >= 18)
Так как обычно всё множество значений (например, множество значений цены) перебрать дорого или невозможно, то возникает потребность не перебирать все значения, а перейти к моделированию областей значений, для значений внутри которых система имеет одинаковое поведение. Для примера выше такими областями являются $[0; 17]$, $[18; 65]$ и $[66; +\infty)$
Такие области называются классами эквивалентности - множества входных или выходных данных, элементы которого, согласно требованиям или спецификации системы, предполагаются обрабатываемыми одинаковым образом, что позволяет использовать отдельные значения этого множества как представителей всего класса при формировании тестовых случаев
В тестировании по технике черного ящика (то есть, когда конкретная реализация неизвестна) применяют разбиение множества входных значений на классы эквивалентности (Equivalence Partitioning, EP)
Помимо числовых диапазонов также классами эквивалентности могут быть элемент из множества перечисления (например, “самовывоз” как способ доставки), пустое значение или некорректный формат (например, строка вместо числа)
Далее при создании тестов выбираются представители классов - одно значение внутри класса эквивалентности, которое будет проверяться, вместо всех значений в этом классе. Поскольку мы предполагаем, что система работает одинаково для всех значений в классе эквивалентности, то может случится ситуация, что дефект может обнаружиться на другом значении, которое не является представителей (принцип, говорящий, что “исчерпывающее тестирование невозможно”)
Другая техника - это анализ граничных значений (Boundary Value Analysis, BVA), при котором тесты проектируются прежде всего для значений на границах классов эквивалентности и непосредственно рядом с ними
Анализ граничных значений хорошо работает с упорядоченной последовательностью значений (например, числа, длина строки, количество элементов), но не с категориальными значениями (такими как цвет, способ оплаты и так далее)
Для примера выше границами классов эквивалентности являются числа $18$ и $65$. Важно также проверять не только границы, но и соседние элементы, где шаг между элементами определяется требованиями (например, для возраста - это $\pm 1$, а для цены - это $\pm 0.01$)
Здесь есть два подхода выбора соседних элементов:
- Две точки - выбираются граница и соседний элемент из другого класса, где меняется поведение, для примера выше это $17$ и $18$
- Три точки - выбираются граница, соседний элемент из того же класса и соседний элемент из другого, для примера выше это $17$, $18$ и $19$
Например, для проверки диапазона $1 \leq x \leq 10$ в двухточечном подходе выбираются точки $0$, $1$, $10$ и $11$, а в трехточечном - $0$, $1$, $2$, $9$, $10$ и $11$
Выбор подхода зависит от тяжести риска, который может нести дефект в этой функции, и стоимости тестирования
Если параметров много, то сочетания их классов эквивалентности образуют декартовое произведение множеств
В случае, когда поведение системы не зависит от сочетания конкретных значений параметров, проверка каждого сочетания не имеет смысла, поэтому можно проектировать тесты так, чтобы каждый значимый класс эквивалентности проверялся хотя бы в одном тесте
Если какие-либо сочетания меняют поведение системы, то они проверяются отдельно, причем важно, чтобы негативные тесты нарушали ровно одно правило, чтобы было понятно в случае дефекта, почему проверка не прошла
На основе этих техник определяется число тест-кейсов, которые проверяют разные границы и классы эквивалентности. Лучше всего проектировать один тест-кейс для проверки одного правила, если важно понять причину провала проверки, но также допустимо делать совместную проверку правил, например, для проверки подсчета цены, зависящей от разных условий
Чтобы тест-кейсы не дублировались, нужно рассматривать цель тест-кейса. Если какие-либо тест-кейсы имеют одинаковую цель, то можно оставить один тест-кейс
Лекция 5. Таблицы решений и комбинации условий
Основная проблема создания тест-кейсов заключается в том, что при большом числе параметров полный перебор комбинаций становится невозможным из-за экспоненциального роста. Например, пусть в магазине есть три параметра: статус VIP-клиента, сумма заказа и промокод - суммарно они уже создают сложные комбинации. Если параметров становится больше, число тестов быстро выходит из-под контроля, поэтому нужны методы сокращения без потери важных проверок
Таблица решений, один из способов записи правил, состоит из 4 компонентов:
- Условия, например, “статус клиента”, “сумма заказа не менее 10000 рублей”, “наличие промокода”
- Значения условий, например, “базовый” и “премиум”, “да” и “нет”
- Действия, например, “скидка 10%”, “скидка 5%” или “отсутствие скидки”
- Правила, то есть столбцы, которые связывают условия с действиями
Правила задаются требованиями, например:
VIP-клиент получает скидку 10% при заказе от 10000 рублей
В остальных случаях действующий промокод предоставляет скидку 5%
Скидки не суммируются: применяется максимальная
В этом примере выделяются ключевые условия: статус клиента, сумма заказа и промокод
При сопоставлении условий, их значений и действий получаем такую таблицу:
| Условие \ Правило | R1 | R2 | R3 | R4 | R5 | R6 | R7 | R8 |
|---|---|---|---|---|---|---|---|---|
| VIP-клиент | ✅ | ✅ | ✅ | ✅ | ❌ | ❌ | ❌ | ❌ |
| Сумма заказа не менее 10000 | ✅ | ✅ | ❌ | ❌ | ✅ | ✅ | ❌ | ❌ |
| Действующий промокод | ✅ | ❌ | ✅ | ❌ | ✅ | ❌ | ✅ | ❌ |
| Действия | ||||||||
| Скидка 10% | ☑️ | ☑️ | ||||||
| Скидка 5% | ☑️ | ☑️ | ☑️ | |||||
| Без скидки | ☑️ | ☑️ | ☑️ |
Классы эквивалентности помогают сократить количество тестов. Например, сумма заказа делится на диапазоны “менее 0”, “от 0 до 9999” и “не менее 10000”, но на логику влияют только два последних, поэтому условие упрощается до используется бинарное сравнение “не менее 10000” и “менее 10000” вместо точного значения суммы
При трех бинарных условиях полная таблица содержит 8 правил, но при увеличении параметров число комбинаций растет экспоненциально, например, 4 параметра по 3 значения дают 81 тест. По этой причине применяются способы сокращения:
-
Удаление лишних условий, если они не влияют на результат
Условия, которые не влияют на логику (например, имя клиента), перечислять не нужно
-
Учет доминирующих условий, когда один параметр делает остальные нерелевантными, например, если пользователь не авторизован, то остальные условия не важны для результата
Если условие не влияет на решение, то его обозначают длинным тире ➖ или “Не важно”
-
Исключение невозможных комбинаций
Если одно условие неприменимо к ситуации с уже установленными другими условиями, то его обозначают как N/A (от Not Available) или “Неприменимо”
Например, если два столбца с одинаковым результатом “VIP-клиенту с заказом на сумму не менее 10000 дают скидку 10%” можно объединить в одну, так как промокод не влияет на действие. Таким же образом исключаются комбинации условий, которые противоречат друг другу (например, “новый клиент” и “пользователь, который был в системе больше года”). Такие комбинации исключаются из позитивных тестов, но могут стать негативными тестами для проверки обработки ошибок, поэтому важно документировать невозможность сценария
Если одинаковые условия приводят к разным результатам, то решение выбирают исходя из выбранной политики:
- Первое подходящее правило (First Applicable)
- Правило с максимальным приоритетом (Highest Priority)
- Выполняются все применимые действия (All Applicable)
- Выбирается лучший или наиболее выгодный результат (Best Result)
- Такой конфликт обрабатывается отдельным правилом (Explicit Conflict)
Таблица решений дополнительно выявляет в требованиях:
- Пропуски, когда комбинация есть, а действие не указано
- Противоречия, когда для одной комбинации заданы несовместимые действия
- Избыточность, когда несколько пунктов требований сводятся к одному правилу
-
Недостижимые условия, когда сценарий логически невозможен
Такое полезно для тестирования API, где в теле запроса можно указать любое значение, в отличие от UI, где выбор может быть заблокирован
После объединения таблица из примера выше сокращается до трех правил (здесь применяется первое подходящее правило):
| Условие \ Правило | R1 | R2 | R3 |
|---|---|---|---|
| VIP-клиент | ✅ | ➖ | ➖ |
| Сумма заказа не менее 10000 | ✅ | ➖ | ➖ |
| Действующий промокод | ➖ | ✅ | ❌ |
| Действия | |||
| Скидка 10% | ☑️ | ||
| Скидка 5% | ☑️ | ||
| Без скидки | ☑️ |
Правило “VIP-клиенту с заказом на сумму не менее 10000 дают скидку 10%” превращается в готовый тестовый сценарий, где предусловие - это “VIP-клиент с заказом 12000”, действие - это “оплатить без применения промокода”, а ожидаемый результат - это “получение скидки 10% к итоговой сумме”
Здесь дополнительные тесты могут проверять граничные значения, в этом примере можно проверить заказы на сумму 9999 и на сумму 10000
Обычно нет надобности отдельно тестировать невлияющее условие (в этом примере проверять те же условия, но с действующим промокодом), но такое решение зависит от критичности логики и риска проявления дефекта в этой части логики
Дополнительные параметры, такие как браузеры, ОС, языки и устройства, усложняют тесты. Например, для 4 параметров “браузер”, “ОС”, “язык” и “роль” по 3 значения полный перебор займет $3^4 = 81$ тест
Полный перебор непрактичен, поэтому используются подходы попарной проверки и проверки всех комбинаций из $T$ параметров
-
Попарная проверка (Pairwise или 2-way) покрывает все пары значений параметров, а не все комбинации, например, “Chrome и Windows”, “Chrome и русский язык”. В таком случае получится всего 9 тестов, которые проверяют все пары параметров:
Тест № Браузер ОС Язык Роль 1 Chrome Windows Русский Гость 2 Chrome macOS Английский Пользователь 3 Chrome Linux Немецкий Администратор 4 Firefox Windows Английский Администратор 5 Firefox macOS Немецкий Гость 6 Firefox Linux Русский Пользователь 7 Safari Windows Немецкий Пользователь 8 Safari macOS Русский Администратор 9 Safari Linux Английский Гость Риск при такой проверке возникает в том, что возможны пропущенные дефекты в редкой комбинации, например “Safari, macOS, немецкий язык и роль администратора”, но предполагается, что основные сценарии учтены
-
Проверка всех комбинаций из $T$ параметров (T-way) увеличивает покрытие, но также и число тестов
При $T = 3$ тесты имеют вид “Chrome, Windows и русский язык”
Количество тестов при попарной проверке и проверке всех комбинаций из $T$ параметров зависит от числа параметров и значений, которые они принимают. Точной формулы нет, но есть оценка снизу: $N_{\min} = \prod_{j = 1}^T V^{\max}_j$ - произведение $T$ наибольших чисел в порядке убывания (чаще всего эта оценка не совпадает с минимальным числом нужных тестов из-за несовместимости некоторых значений параметров или из-за большего числа параметров)
В текущем примере для $T = 3$ $N_{\min} = 3 \cdot 3 \cdot 3 = 27$ тестов, для $T = 4$ - $N_{\min} = 3^4 = 81$ (то есть полный перебор)
Выбор параметра $T$ зависит от критичности функции, стоимости выполнения теста, сложности взаимодействия, истории дефектов и требований к покрытию
Подытожим:
-
Таблицы решений фокусируются на бизнес-правилах, то есть на том, “что делает система”, и требуют детальных требований
На практике таблицы решений обычно оформляют в программах для работы с таблицами (Excel или Google Sheets)
-
Методы попарной проверки и проверки всех комбинаций из $T$ параметров фокусируются на конфигурациях, то есть на том, как система работает в разных условиях
Попарная проверка не моделирует последовательность действий, поэтому проверяются только независимые конфигурации, а каждый тест должен быть автономным
Алгоритм работы для построения таблицы решений и попарных проверок выглядит так:
- Проанализировать требования и выделить условия и действия
- Построить таблицу решений с учётом приоритетов
- Найти пробелы и противоречия в требованиях
- Упростить таблицу, удалив лишние условия
- Сгенерировать тест-кейсы
- Дополнить набор тестами попарной проверки для конфигураций
Лекция 6. Тестирование переходов состояний
Если система имеет несколько состояний, между которыми она может переходить, то она требует отдельного подхода
Одно и то же событие может приводить к разным результатам в зависимости от исходного состояния объекта и другого контекста. Например, нажатие на кнопку “Отмена” в состоянии “Отправлено” в системе отправки опросов может давать мгновенный переход, а в состоянии “Принято” - запускать дополнительные проверки
Таблица решений без указания зависимостей недостаточна для такой системы, так как она показывает комбинации условий и действий, но не последовательность состояний
Поэтому важно понимать связи между состояниями, события, которые создают переходы, и условия переходов
Такую систему можно смоделировать с помощью конечного автомата. Детерминированный конечный автомат (Finite State Machine, FSM) $A = (S, E, T, s_0, F)$ - это структура, состоящая из:
- Множества состояний $S$
- Множества входных символов $E$ (в нашем случае это события, то есть действия пользователя)
- Функции $T \ : \ S \times E \to S$, которая задает правила переходов
- Начального состояния $s_0$
- И множества конечных состояний $F$
Автомат можно описать с помощью ориентированного графа или матрицы состояний и переходов
Если появляется новое состояние, то его добавление в модель определяется его влиянием на логику переходов, событий или на изменение инварианта
Сам переход состоит из нескольких элементов:
- Исходное состояние перехода
- Событие (или триггер), которое вызвало переход, то есть действие пользователя или внешних систем
- Защитные условия (guard conditions)
- Целевое состояние перехода
- Эффект, который производит переход
Система помимо перехода в новое состояние может реагировать на событие по-разному, например, отказать, проигнорировать действие или вернуть ошибку, если переход по такому событию недопустим
В реальных системах автомат состояний может быть сложнее, например, из-за дополнительных условий или глобального состояния. Поэтому определение автомата расширяется до расширенного автомата (Extended Finite State Machine, EFSM) - в нем переход зависит не только от состояния и триггера, но и от дополнительных данных, например флагов. Например, событие “Отменить” в состоянии “Оплачен” допустимо, только если не установлен флаг “Передан в доставку”. Важно помнить, что слишком подробная модель может привести к избыточной детализации и повышению числа комбинаций, а слишком грубая может пропустить важные проверки
Состояния при построении модели выделяются в местах, где меняется логика работы системы. Такие места называются критическими точками, и они разделяют состояния с разным поведением друг от друга. Также состояния могут иметь скрытый от пользователя контекст, из-за которого может меняться поведение, поэтому состояния описывают не только видимую пользователю часть системы
Полнота модели проверяется через матрицу состояний и событий, которая указывает следующее состояние по переходу из данного, например:
| Состояние \ Событие | Оплатить | Отменить | Доставить | Создать |
|---|---|---|---|---|
| ✅ Заказ создан | 💵 Заказ оплачен | ❌ Заказ отменен | Не определено | Не определено |
| 💵 Заказ оплачен | Состояние не меняется | Не определено | 📦 Заказ доставлен | Отказ |
| 📦 Заказ доставлен | Отказ | Не определено | Состояние не меняется | Отказ |
| ❌ Заказ отменен | Отказ | Состояние не меняется | Отказ | ✅ Заказ создан |
В такой матрице видно, какие переходы определены, а какие нет, поэтому легко выявляются возможные проблемы:
- Неопределенность поведения в требованиях (здесь это, например, переход по событию “Отменить” из состояния “Заказ оплачен”)
- Забытые переходы
- Тупиковые состояния - такие неконечные, переходы из которых не ведут к конечному состоянию
Для сохранения детерминизма результат должен быть уникальным для заданной комбинации состояния, события и данных
Если есть несколько возможных переходов, удовлетворяющих условию, то возникает конфликт. Такие конфликты решаются через взаимоисключающие защитные условия или через приоритеты условий
Графическое представление модели в виде графа помогает выявить недостижимые узлы, состояния-тупики и циклы без выхода к финальному состоянию. Например, состояние без входящих стрелок указывает на то, что до него нельзя добраться из начального состояния
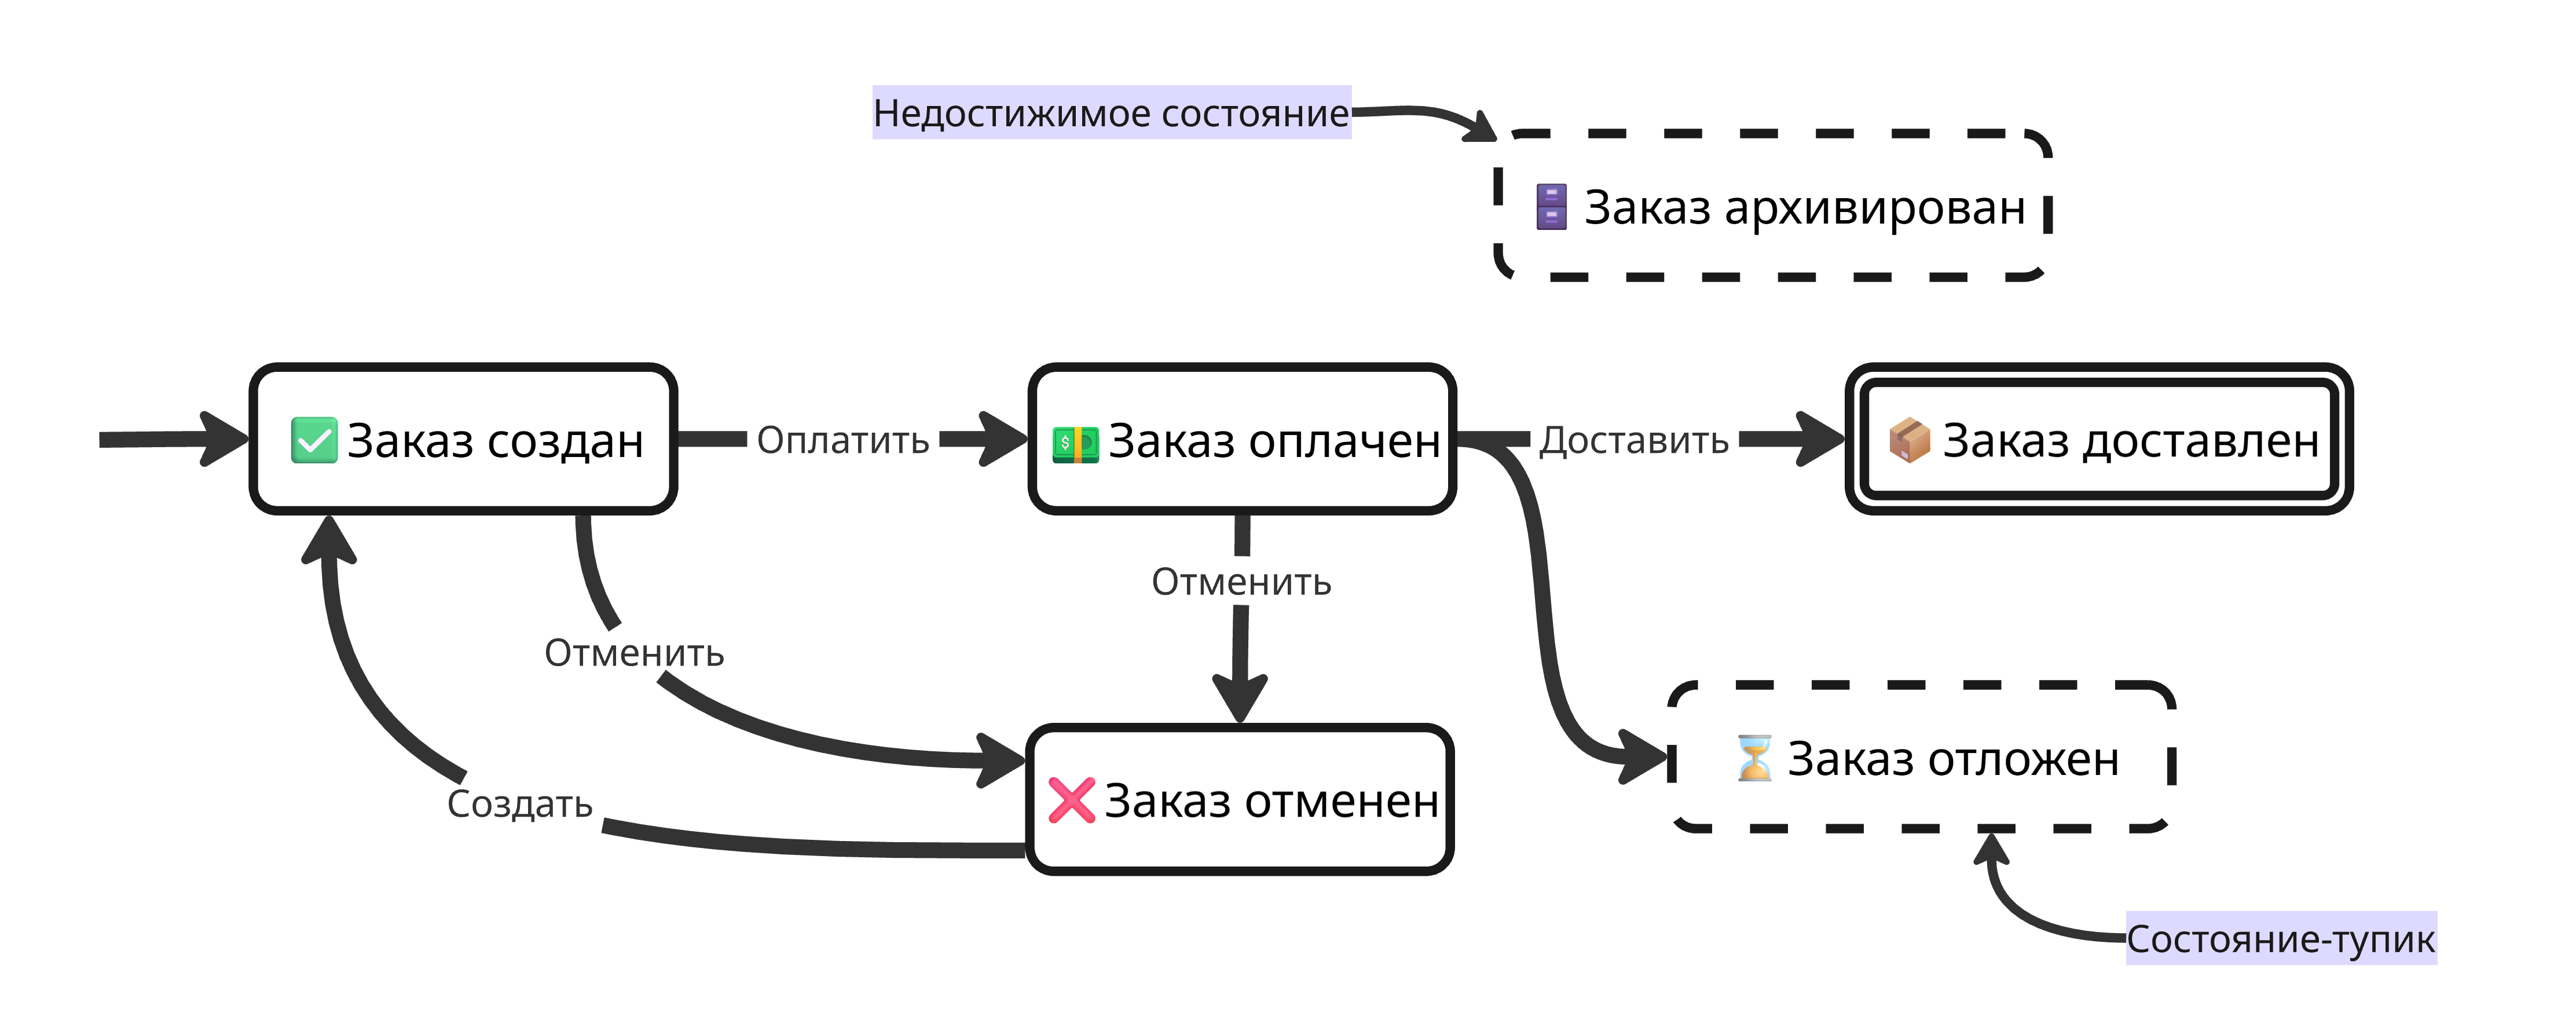
Также важно учитывать инварианты - свойства, которые не должны меняться после определенного события. Например, при оплате идентификатор платежа не должен меняться, поэтому в ходе проверки важно проверять, что он остается постоянным
Обычный конечный автомат плохо масштабируется из-за того, что при росте числа состояний и событий матрица переходов становится громоздкой, а одинаковые переходы приходится повторять для многих состояний. Для решения этой проблемы используют расширение модели:
-
Вложенное состояние - такое состояние, внутри которого находится свой набор состояний. Внешнее состояние называют составным (суперсостоянием), а внутренние - подсостояниями
Например, у заказа есть составное состояние “Активный”, внутри которого находятся подсостояния “Ожидание оплаты”, “Оплачен” и “Упаковка”. Переход на составном состоянии срабатывает из любого подсостояния, поэтому такой переход нужно проверять из каждого подсостояния
-
Некоторые части системы изменяются независимо друг от друга. Тогда вместо одного большого автомата строят несколько, которые работают одновременно - параллельные автоматы. Тогда состояние всей системы - это набор текущих состояний каждого автомата
Например, жизненный цикл заказа можно разделить на два автомата:
- Оплата: “Не оплачен”, “Оплачен”, “Возвращён”
- Обработка: “Не собран”, “Собран”, “Отправлен”
Такие два автомата имеют меньше состояний, чем один большой, поэтому их проще тестировать отдельно друг от друга
Риск детализации состоит в том, что при попытке охватить все независимо изменяющиеся атрибуты возникает увеличение числа комбинаций. Поэтому модель должна отвечать на конкретные вопросы тестирования, а не описывать систему целиком
Преобразование модели в тесты делается так:
- Предусловия, то есть начальное состояние и данные
- Действия, то есть события
- Ожидаемый результат, то есть смена на нужное состояние, эффекты перехода и несменяемость инварианта
Например, для модели выше можем получить тест-кейс с предусловием “Начальное состояние - ‘Заказ создан’”, действием - “Совершить событие ‘Оплатить’” и ожидаемым результатом “Новое состояние - ‘Заказ оплачен’”
Негативные сценарии берутся из матрицы переходов, где есть запрещенные комбинации состояний и переходов, и из граничных случаев. В негативных тестах важно проверять не только код ошибки, но и отсутствие побочных эффектов: изменения в базе данных, лишних запросов и других нежелательных действий
Покрытие тестов можно проверять по критериям:
- Проверка всех состояний (но такой тест может не проверить все переходы)
- Проверка каждого перехода (0-switch)
- Проверка каждой пары связных переходов (1-switch)
- В общем случае проверка каждой цепочки из $N + 1$ переходов ($N$-switch)
Чем больше $N$, тем строже критерий покрытия и больше тестов. Число $N$ выбирается исходя из рисков
В итоге, этапы работы выглядят так:
- Сбор информации из требований или других источников
- Построение модели
- Анализ модели (поиск тупиков и избыточности)
- Обновление модели
- Генерация тест-кейсов
- Оценка покрытия
- Выполнение тестов
Лекция 7. Исследовательское тестирование
Бывают ситуации, когда продукт еще совсем новый, четких требований и документации по нему нет, поэтому помогает исследовательское тестирование (Exploratory testing) - подход, при котором тестировщик одновременно изучает программу, придумывает тесты и сразу же их выполняет
При тестировании важно учитывать, что:
- Целесообразнее проверять компоненты, дефект в которых приведет к более серьезным последствиям
- Тестирование помогает понять, что известные нам дефекты не найдены, а не то, что у продукта дефектов нет вообще
Методы исследовательского тестирования помогают решить эти проблемы, а именно найти новые возможные дефекты и понять, какие лучше проверять первыми
В обычном, скриптовом тестировании (Scripted testing) уже задан план проверок (то есть список тест-кейсов), которые выполняются, и на основе выполнения которых образуется отчет тестирования системы
В исследовательском тестировании цикл проверки состоит из исследований системы:
- Наблюдение за системой
- Формирование гипотезы. Хорошая гипотеза связана с наблюдением, указывает условия и допускает проверку, например, “После таймаута повтор оплаты может создать два заказа”
- Проверка гипотезы
- Анализ результата
- На основе результата принимаем решение, в каком направлении двигаться, например, при наблюдении может произойти неожиданное поведение в другом компоненте
Ожидаемое поведение определяют бизнес-требования. Но в исследовательском тестировании бизнес-требований зачастую нет, поэтому используют тестовый оракул - источник или принцип, по которому определяют ожидаемое поведение системы
Тестовым оракулом может быть: требование, бизнес-правило, спецификация API, предыдущее поведение, предметная область, согласованность интерфейса или ожидания пользователя
При наблюдении часто нет четкого ответа, является ли поведение системы правильным, вместо этого возникают вопросы (например, “является ли этот пользовательский сценарий логичным”) или подозрение (например, “дизайн интерфейса этого экрана не согласуется с дизайном другого экрана”)
Кроме этого, вывод из наблюдения зависит от контекста, например, из наблюдения “после отмены оплаты промокод больше нельзя использовать” может следовать, что это корректное поведение, если есть правило “промокод списывается после попытки оплаты”, или дефект, если есть правило “промокод списывается после успешной оплаты”
При наблюдениях важно фиксировать цель наблюдения, объяснять выбор проверок и сохранять важные наблюдения
Полный цикл исследования, посвященный одной цели, называют сессией
Чтобы исследование не затягивалось, сессии ограничивают по времени (такое ограничение называют таймбоксом). Также ограничивают область исследования - такая граница называется чартером. Чартер описывает не только функциональную область, но и потенциальный риск. Примером хорошего чартера является “исследовать восстановление оформления заказа после сбоя оплаты, чтобы оценить риск потери заказа или двойного списания”
Для появления идей чаще всего помогают эвристики, которые возникают из понимания предметной области
В качестве инструментов для исследования помимо эвристик и чартера используют тест-кейсы и чек-листы
Для исследования также определяют по мнемонике SFDPOT:
- Структура (Structure) - то, из чего состоит продукт
- Функция (Function) - то, что делает продукт
- Данные (Data) - то, что обрабатывает продукт
- Платформа (Platform) - окружение, на котором работает продукт
- Операции (Operations) - то, как используют продукт люди
- Время (Time) - временные аспекты (скорость работы, таймауты и другое)
Дополнительно добавляют интерфейсы (то, как продукт взаимодействует с внешним миром), получая SFDIPOT
Также SFDPOT помогает выбрать направления для проверки
По модели покрытия можно понять, какой функционал системы исследован, а какой еще нет. Покрытие можно измерять по 6 аспектам: функции, состояния, риски, ошибки, платформы и данные
Само тестирование гипотезы производится из ранее изученных техник: классы эквивалентности и анализ граничных значений, таблицы решений, переходы состояний и так далее
По результатам исследовательского тестирования можно сохранить журнал действий, например, кликов. Такой журнал представляет собой сырые данные, которые сами по себе малоинформативны. Важно из этого журнала извлечь: цель сессии, ключевое наблюдение, проверенную гипотезу, свидетельство и результат, решение о смене направления, вопросы и новые риски
Свидетельство формируется из наблюдения, контекста, в котором наблюдение было сделано, и интерпретации того, какие риски могут возникнуть
По результатам сессии формируются:
- Найденные дефекты
- Подтвержденные наблюдения
- Новые риски
- Вопросы к аналитикам или бизнесу
- Тестовые идеи
- Уточненная модель продукта
- Идеи (чартеры) для новых сессий
Оценка рисков
Источниками рисков могут быть, например, данные пользователей, интеграции, необратимые действия, потеря финансов и так далее
При анализе риска формируются ответы на вопросы “насколько вероятно нежелательное событие?” и “насколько серьезным будет влияние?”. Далее риск оценивается по тяжести последствий и вероятности появления. Наибольший приоритет у тех рисков, где высоки и вероятность, и тяжесть последствий
На вероятность влияют сложность логики, большой объем изменений, появление похожих прошлых дефектов, нестабильность тестов, внешние зависимости и слабая наблюдаемость
Тяжесть последствий оценивается по ответам на вопросы:
- Видит ли проблему клиент?
- Нарушен ли ключевой поток?
- Сколько пользователей затронуто?
- Затрагиваются ли деньги или персональные данные?
- Можно ли восстановиться?
- Влияет ли это на доверие и репутацию?
На основе этого составляется список рисков, которые располагаются на матрице рисков с осями тяжесть-вероятность
Также риски можно поделить на два типа:
- Продуктовый риск - “что может быть не так с продуктом?”
- Проектный риск - “что может помешать команде выпустить продукт?”
Также бывают ситуации, когда нет возможности оценить риск (например, из-за недоступности интеграций), важно зафиксировать такие ситуации как “остаточный риск”, чтобы в последствии уточнить с заказчиком
После исследовательской сессии также возможна повторная оценка риска. Риск с наибольшими тяжестью последствий и вероятностью проверяют не только как можно раньше, но и как можно тщательней
Вечно тестировать и исследовать невозможно, поэтому останавливаться стоит, когда:
- Миссия сессии достигнута
- Истек таймбокс
- Ключевые риски получили достаточные свидетельства
- Следующая проверка имеет низкую ожидаемую ценность
- Остаточный риск явно принят заказчиком (например, когда срок релиза уже близко)
Лекция 8. Дефекты и баг-репорты
Дефект (или баг, bug) появляется тогда, когда ожидаемое поведение не совпадает с фактическим. Обычно у дефекта может быть множество причин появления, что позволяет сформулировать гипотезу появления дефекта
Термин “баг” возник из слова bug (с англ. жук, букашка) и популяризировался после случая 1947 года, когда в реле вычислительной машины Harvard Mark II обнаружили мотылька, вызвавшего сбой
Здесь важно понимать различие между фактическим поведением (тем, что произошло) и ожидаемым поведением (тем, что должно произойти)
У ожидаемого поведения может быть множество источников (например, требования, бизнес-правила или критерии проверки). Как правило, используют тестовый оракул, но если у ожидаемого поведения есть несколько источников, которые противоречивы, то требования уточняются с заказчиком. Далее фиксируются сценарий и условия воспроизведения
После этого оценивается влияние этого дефекта на пользователей. Для дефекта выделяют:
- Серьезность (Severity) отражает тяжесть последствий при проявлении дефекта. В зависимости от продукта и появляющихся рисков серьезность оценивается по-разному. Самым серьезным последствием можно считать потерю данных пользователей, а наименее серьезным - визуальные дефекты интерфейса
- Приоритет (Priority) описывает, насколько срочно нужно исправить дефект. На приоритет, как правило, влияют количество затронутых этим дефектом пользователей, договорные обязательства, сроки релиза и стоимость задержки
Как правило, серьезность и приоритет напрямую не связаны, например, опечатка в названии компании на главной странице имеет низкую серьезность, но высокий приоритет
Риск оценивают по серьезности и вероятности проявления дефекта, а приоритет, определяющий порядок исправления дефектов в списке, оценивают по риску и другим бизнес-факторам
Далее заполняется отчет, который описывает дефект:
-
Идентификатор в базе данных
-
Заголовок
В заголовке отчета лучше сочетать место проявления дефекта (конкретный функционал), условие и наблюдаемое отклонение. Пример заголовка “Не работает оплата” плохой, а “Оформление заказа: повторное нажатие “Оплатить” после таймаута создаёт второй заказ” - хороший
-
Условия, в которых проявился дефект
Условия представляют собой среду (например, устройство, браузер, ОС, сборка приложения и так далее) и состояние системы до первого шага, например, авторизация пользователя
-
Шаги воспроизведения
Шаги воспроизведения должны быть простыми действиями, которые приводят к дефекту. В отчете важно минимизировать шаги воспроизведения и оставить ровно те, которые позволяют воспроизвести его
-
Ожидаемый результат и фактическое поведение
Ожидаемое и фактическое поведение должны быть описаны конкретно и проверяемо
-
Свидетельства проявления дефекта (например, фото, видео, логи и другое)
-
Серьезность и приоритет
-
Статус дефекта, обычно выделяют: открытый (Open), в процессе исправления (In progress), исправленный (Fixed), подтвержденный (Verified) закрытый (Closed) и другие
Чаще всего такой отчет будет читать кто-то другой (даже если прошло несколько лет), поэтому отчет должен быть однозначным и понятным
Нередко дефекты воспроизводятся не каждый раз из-за невыявленных условий - тогда измеряют воспроизводимость - частоту проявления дефектов в одинаковых условиях (обычно записывают число из общего числа проверок, например, 3 из 10)
На воспроизводимость могут повлиять данные и состояние системы, текущее время (например, при повышенной нагрузке в пиковые часы дефект может проявляться чаще), состояние сети, конкурентные события, кэш и окружение
На основе фактов из отчета формируют гипотезу таким образом, чтобы сузить множество потенциальных причин появления дефектов. Поэтому гипотеза должна быть фальсифицируема, то есть можно придумать проверку, которая гипотезу опровергнет. Например, гипотеза “дефект проявляется только при включённом кэше” проверяется отключением кэша. В результате происходит локализация дефекта до конкретного программного слоя/компонента (например, клиент, сервер, база данных, сеть или интеграция)
Для веб-приложений в частности применяются инструменты разработчика, встроенные в браузер. В Firefox и браузерах на основе Chromium инструменты разработчика открываются по кнопке F12 и включают:
- Вкладка “Элементы”/”Инспектор”, где перечислены элементы объектной модели HTML-документа (DOM, Document Object Model)
- Вкладка “Консоль”, где могут быть указаны ошибки скриптов
- Вкладка “Сеть”, где указаны исходящие/входящие запросы, их содержание, статус и время выполнения
- Вкладка “Источники”/”Отладчик”, где можно посмотреть используемые текущим сайтом документы, такие как CSS-стили, и можно отладить скрипты на языке JavaScript
- Вкладка “Приложение” в Chromium и “Хранилище” в Firefox, где можно узнать локальное состояние сайта (локальное хранилище, сессионное хранилище, кэш, куки-файлы и так далее)
Для анализа REST API отлично подходят утилита curl или приложение Postman
Важно помнить, что HTTP-код может неточно указывать полученный результат (например, при HTTP-коде 200 тело ответа может содержать информацию о какой-либо ошибке). Помимо этого нужно учитывать сетевую конфигурацию: состояние DNS, TLS-сертификатов, наличие VPN
Для тестирования мобильных Android-приложений используется среда разработки Android Studio и инструмент журналирования Logcat. Для iOS-приложений используется среда разработки Xcode
Для диагностики настольных приложений используется “Диспетчер задач” (Task Manager) в Windows или соответствующий аналог в Linux (например, System Monitor в среде KDE или консольные утилиты top/btop). Для продвинутой диагностики используются соответствующие среды разработки, например, Visual Studio предоставляет широкий инструментарий для отладки и профилирования приложений на C++ и платформе .NET
Далее после исправления дефекта проводят повторную проверку, чтобы подтвердить его отсутствие
В итоге диагностический цикл получается таким:
- Воспроизведение дефекта
- Минимизация шагов для воспроизведения
- Фиксация дефекта в отчете
- Формулировка гипотезы
- Локализация причин появления
- Выбор инструмента для диагностики
- Получение фактов
- Проверка гипотезы
- Обновление отчета
- Повторная проверка после исправления